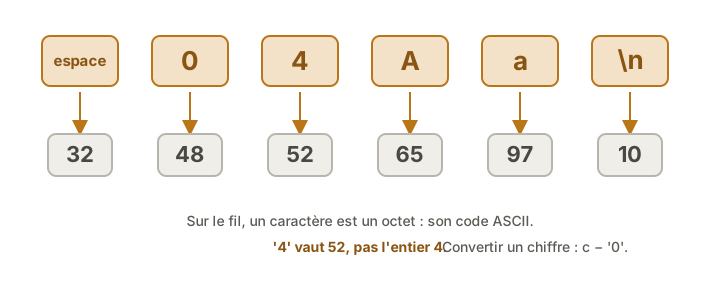
Le code ASCII (American Standard Code for Information Interchange) est une table qui associe chaque caractère du texte — lettres, chiffres, ponctuation — à un nombre entre 0 et 127. C’est la convention par laquelle une carte et un ordinateur s’échangent du texte : sur le fil, un caractère n’est jamais « la lettre A », c’est l’octet 65.
À quoi ça sert ?
Comprendre l’ASCII, c’est comprendre pourquoi un programme ne « voit » pas le texte comme nous. Quand on tape 4 au moniteur série, la carte ne reçoit pas l’entier 4 : elle reçoit l’octet 52, le code du caractère '4'. D’où le piège classique de Serial.read() : recevoir '4' puis '2' (52 puis 50) au lieu du nombre 42.
Cette distinction caractère / nombre revient partout en embarqué :
- Liaison série. Chaque octet reçu est un code ASCII. Lire un nombre suppose de reconstituer les chiffres un à un (ou de laisser faire
Serial.parseInt()). - Type
char. En C++, uncharest un entier sur 8 bits (voir les types) :'A'et65sont la même valeur, et'A' + 1vaut'B'. - Conversion chiffre ↔ valeur. Le code d’un chiffre se déduit par décalage :
'0'valant 48, le chiffrens’écrit'0' + n, et un caractère-chiffre se reconvertit en valeur parc - '0'.
Quelques repères
Les plages utiles à connaître (le reste se retrouve dans n’importe quelle table ASCII) :
- « 0 »–« 9 » → 48 à 57 (
'0'= 48) - « A »–« Z » → 65 à 90 (
'A'= 65) - « a »–« z » → 97 à 122 (
'a'= 97, soit 32 de plus que les majuscules) - espace → 32
- saut de ligne
\n→ 10, retour chariot\r→ 13 - 0 à 31 → caractères de contrôle (non imprimables : tabulation, fin de ligne…) ; 32 à 126 → caractères imprimables.
Pour retrouver un code précis, la table complète se lit d’un coup d’œil :
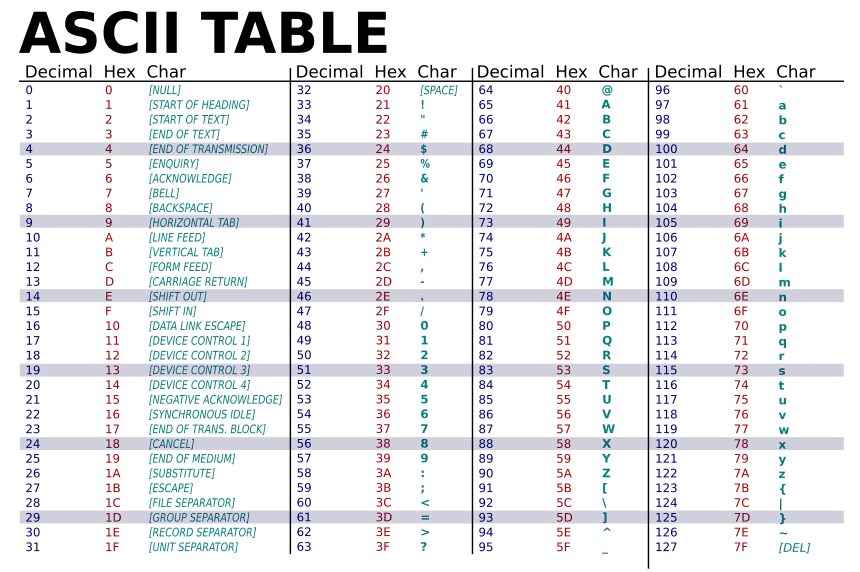
Chaque ligne décrit un caractère et se lit de gauche à droite, sur trois colonnes :
- Decimal — le code en base 10, le nombre 0-127 manipulé jusqu’ici (
'A'= 65). - Hex — la même valeur écrite en base 16, notée
0x..: c’est la forme qu’affichent les datasheets, les vidages mémoire et le moniteur série en mode HEX.'A'= 65 en décimal s’écrit0x41en hexadécimal. Les deux désignent le même octet, seule la base d’écriture change. - Char — le caractère lui-même, ou son nom entre crochets pour les codes 0 à 31, qui ne s’impriment pas (
[LINE FEED]=\n= 10 =0x0A,[CARRIAGE RETURN]=\r= 13).
Les quatre blocs se suivent simplement : 0-31 (contrôle), 32-63 (espace, chiffres, ponctuation), 64-95 (majuscules), 96-127 (minuscules).
Tip
Trois ancres suffisent. Inutile de retenir la table entière : espace = 32,
'0'= 48,'A'= 65. Et les minuscules sont 32 plus loin que les majuscules. Tout le reste se déduit.
Au-delà de 127 — Unicode et UTF-8
L’ASCII d’origine ne couvre que 128 valeurs (7 bits) : ni é, ni €, ni les alphabets non latins. Les caractères au-delà relèvent d’UTF-8 (le standard du web et des fichiers modernes), où un caractère accentué occupe plusieurs octets. Conséquence concrète : "é" n’est pas un octet mais deux, et un char C++ ne peut pas le contenir seul. Sur une liaison série, traiter du texte accentué caractère par caractère via Serial.read() casse les accents : raison de plus pour s’en tenir à l’ASCII (a–z, 0–9, ponctuation simple) dans les protocoles embarqués.
Voir aussi
- Moniteur série Arduino — là où le piège caractère/nombre se rencontre en premier (
Serial.read()) - Moniteur série ESP32 — le même piège caractère/nombre côté ESP32
- Les types en C++ — le type
char, entier 8 bits qui porte un code ASCII - Manipulation de bits — un caractère est un octet, manipulable bit à bit
- C++ — le langage où
'A'et65sont interchangeables